Отчёт по текущему этапу разработки русскоязычного философского LLM-бенчмарка
1. Общие сведения
На текущем этапе создан и технически проверен воспроизводимый контур русскоязычного философского LLM-бенчмарка. Он включает:
- русскоязычные философские источники и их смысловое разбиение на чанки;
- экспертные вопросы и эталонные ответы;
- короткие и длинные ответы нескольких моделей-респондентов;
- оценивание ответов специализированной моделью-судьёй POLLUX;
- альтернативное оценивание моделью-судьёй GLM-5.2;
- сопоставление оценок моделей-респондентов с экспертными оценками экспертов-философов;
- анализ различающей способности критериев;
- отдельный контур автоматической проверки и дисквалификации ответов с лексическими и языковыми дефектами;
- формирование «золотого набора» из пяти наиболее информативных критериев.
Основной результат этапа состоит не в выборе окончательного победителя среди моделей-респондентов, а в установлении границ применимости автоматической модели-судьи.
Исследование показало:
- POLLUX нельзя использовать как автономную окончательную модель-судью философских ответов. Корреляция с экспертами-философами на собственной восьмикритериальной архитектуре составляет \(r = 0{,}385\).
- Замена POLLUX на GLM-5.2 несколько повышает согласованность с экспертами-философами, хотя GLM-5.2 не проходила специализированного обучения на данном наборе критериев: \(r = 0{,}445\).
- Выбор модели-судьи существенно меняет результаты. Даже на одинаковых критериях POLLUX и GLM-5.2 по-разному используют шкалу и ранжируют ответы.
- Большое количество критериев не гарантирует качество измерения. Половина критериев Article10 на полном наборе из 291 ответа оказалась полностью вырожденной: GLM-5.2 присвоила каждому ответу максимальный балл.
- Длина ответа создаёт сильное систематическое смещение у POLLUX. Все шесть сопоставимых моделей получили за длинные ответы более высокие оценки, чем за короткие; разрыв достигает 13,0 процентного пункта.
- Модель-судья недостаточно надёжно распознаёт лексические дефекты и псевдотерминологию. Поэтому языковая корректность должна проверяться отдельным детерминированным слоем.
- После дисквалификации ответы с языковыми дефектами перестают искусственно поднимать рейтинг моделей. Итоговый автоматический рейтинг становится существенно ближе к экспертному, особенно на крайних позициях.
Наиболее обоснованная архитектура следующего этапа:
философский источник → экспертный вопрос → эталонный ответ → ответ модели-респондента → детерминированная языковая проверка → оценивание по калиброванным критериям → сопоставление с экспертами-философами → профиль ошибок и итоговый рейтинг.
2. Исходная постановка задачи
2.1. Что именно должен измерять философский бенчмарк
Цель проекта — создать воспроизводимый русскоязычный бенчмарк для исследования философской компетентности больших языковых моделей.
Под философской компетентностью понимается способность модели:
- корректно работать с философскими понятиями;
- реконструировать позиции авторов и традиций;
- опираться на содержание источника;
- отличать описание позиции от её критики;
- строить связное философское рассуждение;
- отвечать на вопросы разных типов и уровней сложности;
- сохранять содержательную точность, а не только риторическую убедительность;
- использовать корректную русскоязычную философскую терминологию.
Бенчмарк не предназначен для определения «единственно правильной философии». Его задача практичнее: выяснить, насколько ответ модели соответствует экспертно заданному содержательному ориентиру и насколько система оценки способна отличить сильный ответ от слабого.
2.2. Разделение ролей
В эксперименте принципиально разделены три роли:
| Роль | Функция |
|---|---|
| Модель-респондент | Отвечает на философский вопрос. |
| Модель-судья | Оценивает ответ по заданным критериям. |
| Эксперт-философ | Формирует экспертный ориентир для сравнения и содержательно интерпретирует ответы. |
Это разделение необходимо, потому что высокая оценка автоматической модели-судьи сама по себе ещё не означает высокого качества ответа. Сначала требуется установить, насколько поведение модели-судьи согласуется с экспертными оценками экспертов-философов.
Глоссарий
Короткий ответ
Короткий ответ модели-респондента объёмом два-три предложения.
Длинный ответ
Длинный ответ модели-респондента объёмом пять-шесть предложений.
Модель-респондент
Большая языковая модель, которая отвечает на вопросы философского бенчмарка. Полученные ответы затем оцениваются моделью-судьёй и, в предусмотренной части исследования, экспертами-философами.
Модель-судья
Большая языковая модель, которая оценивает ответы моделей-респондентов по заданным критериям и шкалам.
POLLUX
Специализированная модель-судья, обученная или дообученная для автоматического оценивания ответов по критериям набора POLLUX.
POLLUX8
Выбранный для философского исследования набор из восьми наиболее информативных критериев POLLUX:
- непротиворечие фактам реального мира;
- отсутствие артефактов;
- полезность;
- доступность;
- креативность;
- естественность и несинтетичность речи;
- глубина проработки ответа;
- формальный учёт требований из запроса пользователя.
Article10
Набор из десяти критериев, сформулированных предыдущей командой проекта для статьи о философском бенчмарке:
- философская точность;
- логическая связность;
- информационная плотность;
- глубина философского анализа;
- эпистемическая осторожность;
- отсутствие предвзятости;
- риторическая уместность;
- структурная полнота рассуждения;
- валидность переходов;
- источниковая обоснованность.
Различающая способность критерия
Способность критерия давать достаточную вариативность оценок и различать ответы разного качества. Если критерий присваивает всем или почти всем ответам одинаковые баллы, он не обеспечивает необходимой разрешающей способности бенчмарка.
«Золотой набор» из пяти критериев
Рабочий набор из пяти наиболее информативных критериев, отобранных из POLLUX8 и Article10:
- глубина философского анализа — Article10;
- философская точность — Article10;
- глубина проработки ответа — POLLUX8;
- естественность и несинтетичность речи — POLLUX8;
- источниковая обоснованность — Article10.
Все пять критериев имеют одинаковый вес. Точный расчёт раскрыт в разделе 6.
3. Данные и экспериментальная схема
3.1. Экспертные оценки моделей-респондентов
Для сопоставления автоматических и экспертных оценок использованы:
- 280 экспертных оценок;
- 14 философских вопросов;
- шкала экспертной оценки от 1 до 5;
- шесть моделей-респондентов.
Состав шести моделей для экспертного сопоставления:
- GPT-5.6 SOL;
- GLM-5.2;
- DeepSeek V4 Pro;
- kimi-k3;
- Qwen 3.6 35B A3B;
- AliceAI.
По отношению к шестимодельному составу основного корпуса DeepSeek V3.2 заменяется на DeepSeek V4 Pro, а GPT-5.3 Codex Spark — на kimi-k3.
3.2. Основной корпус ответов
Основной корпус включает:
- 24 философских вопроса;
- 291 ответ;
- короткие и длинные ответы;
- шесть моделей-респондентов.
Сопоставимый состав основного корпуса:
- GPT-5.6 SOL;
- GLM-5.2;
- DeepSeek V3.2;
- GPT-5.3 Codex Spark;
- Qwen 3.6 35B A3B;
- AliceAI.
4. Согласованность моделей-судей с экспертами-философами
Первый блок исследования посвящён сопоставлению оценок моделей-судей с оценками экспертов-философов. Проверялась согласованность оценок POLLUX, полученных по разным критериям, с экспертными оценками. Почти на всех наборах вопросов и критериев POLLUX показала низкую корреляцию с экспертами. Наиболее высокая из полученных корреляций достигнута при использовании критериев исходного набора POLLUX, на которых модель была дообучена.
В исходном наборе POLLUX содержится 15 критериев. Для философского исследования из них были выбраны восемь наиболее информативных: 1, 4, 5, 8, 10, 11, 12 и 15. Исходный набор POLLUX опубликован на Hugging Face.
Рисунок 4.1. Экспертные оценки и модель-судья POLLUX
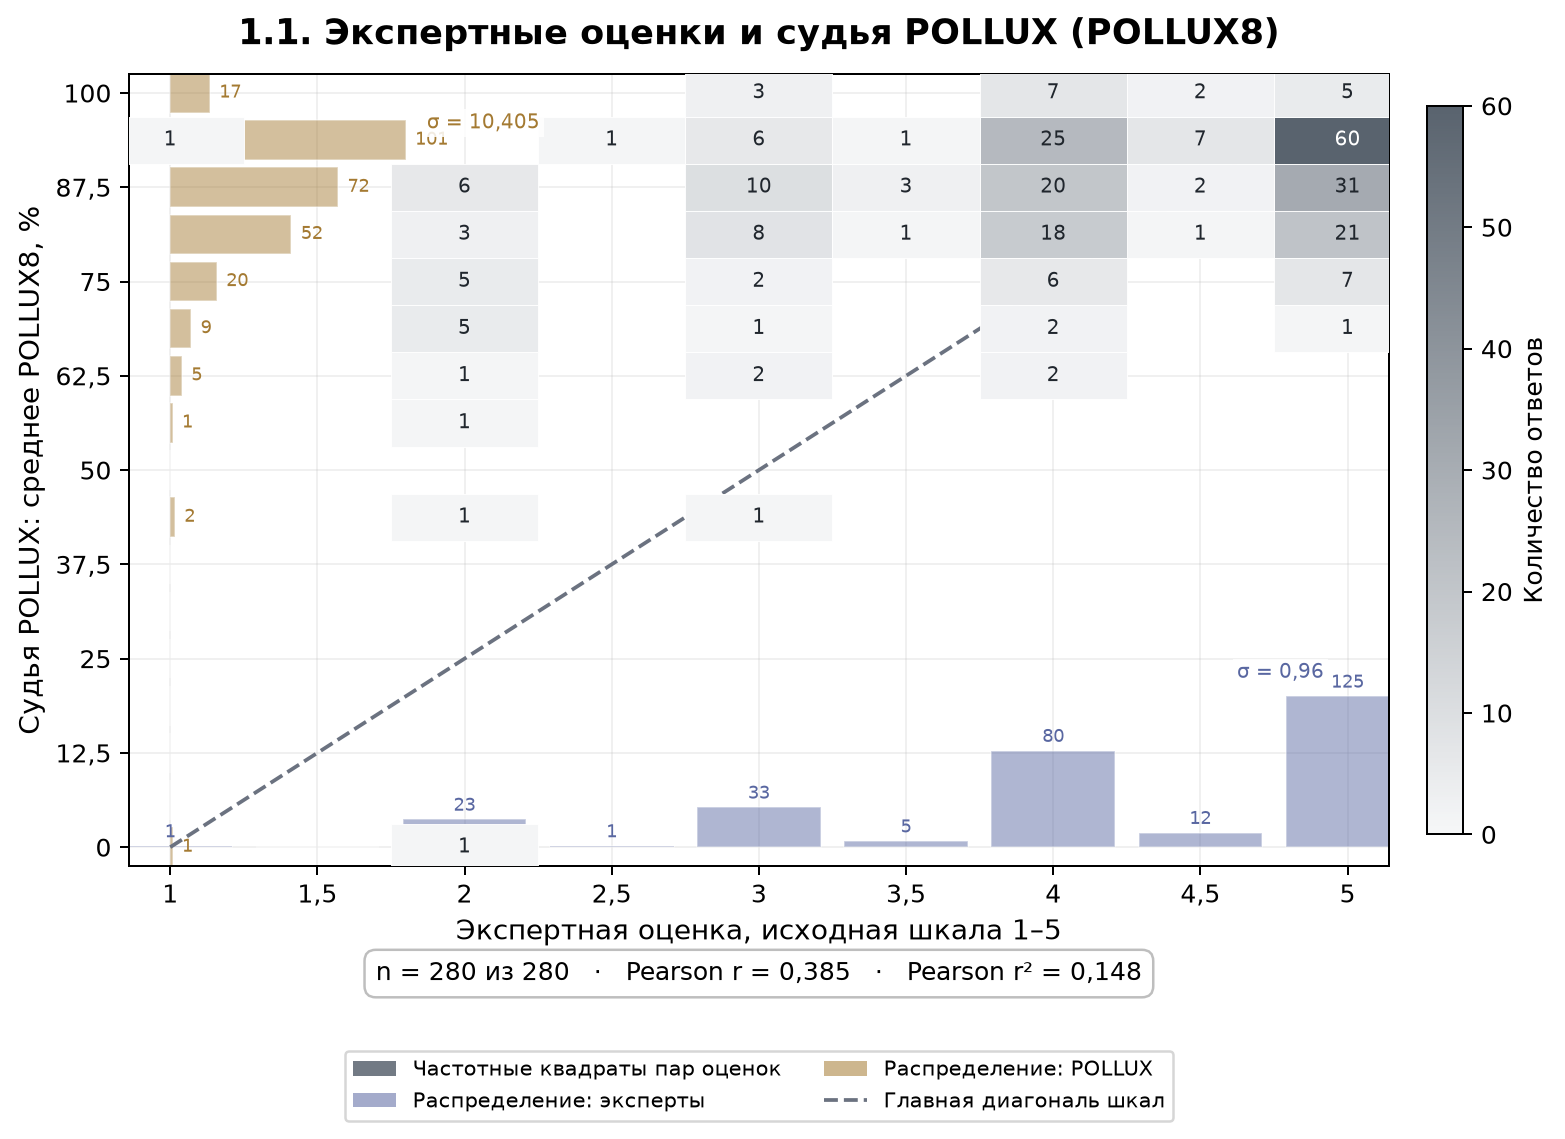
Рисунок 4.1. Экспертные оценки и модель-судья POLLUX.
Интерпретация
Связь между оценками существует, но она недостаточна для автономной модели-судьи. Значение \(r = 0{,}385\) означает, что высокие экспертные оценки лишь отчасти сопровождаются высокими оценками POLLUX. Значительная часть вариативности экспертных суждений остаётся неотражённой.
POLLUX различает некоторые ответы, но плохо воспроизводит экспертный порядок, концентрирует оценки в высокой части шкалы, не обладает достаточной разрешающей способностью и местами оценивает ответы выше, чем следует из экспертного результата.
Специализированная модель-судья POLLUX на собственном наборе критериев демонстрирует только ограниченную согласованность с экспертами-философами. Это не означает, что оценки POLLUX полностью случайны, однако корреляция недостаточна, чтобы считать модель надёжной заменой экспертной проверке.
Рисунок 4.2. Экспертные оценки и модель-судья GLM-5.2
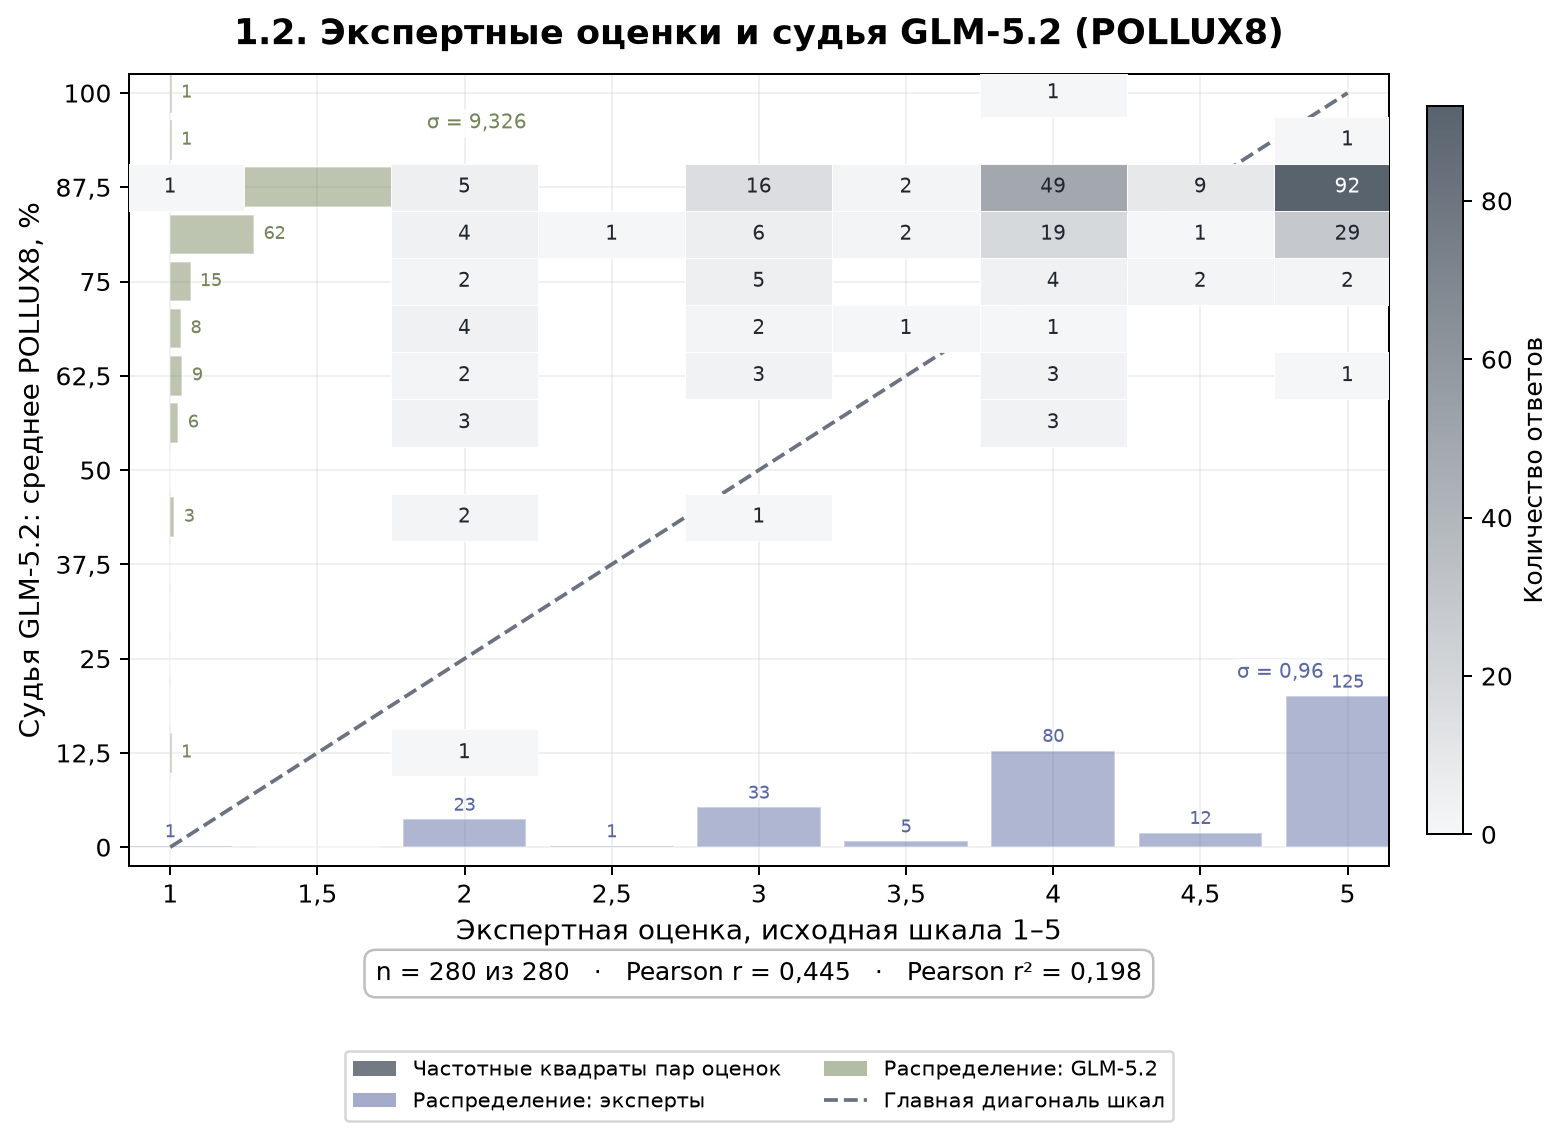
Рисунок 4.2. Экспертные оценки и модель-судья GLM-5.2.
Интерпретация
GLM-5.2 показывает более высокую корреляцию с экспертами-философами: POLLUX — 0,385; GLM-5.2 — 0,445. Разница не доказывает окончательного превосходства GLM-5.2. Обе величины всё ещё находятся далеко от уровня, достаточного для надёжного автономного оценивания.
Современная универсальная модель, получившая критерии в виде обычной текстовой инструкции, согласуется с экспертами несколько лучше специализированной модели-судьи. Это ставит под вопрос достаточность специализированного обучения POLLUX, переносимость её критериев на философскую предметную область и целесообразность выбора POLLUX как основной модели-судьи без дополнительной калибровки.
Оценки GLM-5.2 ещё более сжаты: стандартное отклонение ниже, чем у POLLUX. Следовательно, небольшое повышение согласованности с экспертами не решает проблему недостаточной различающей способности.
Рисунок 4.3. Согласованность моделей-судей POLLUX и GLM-5.2
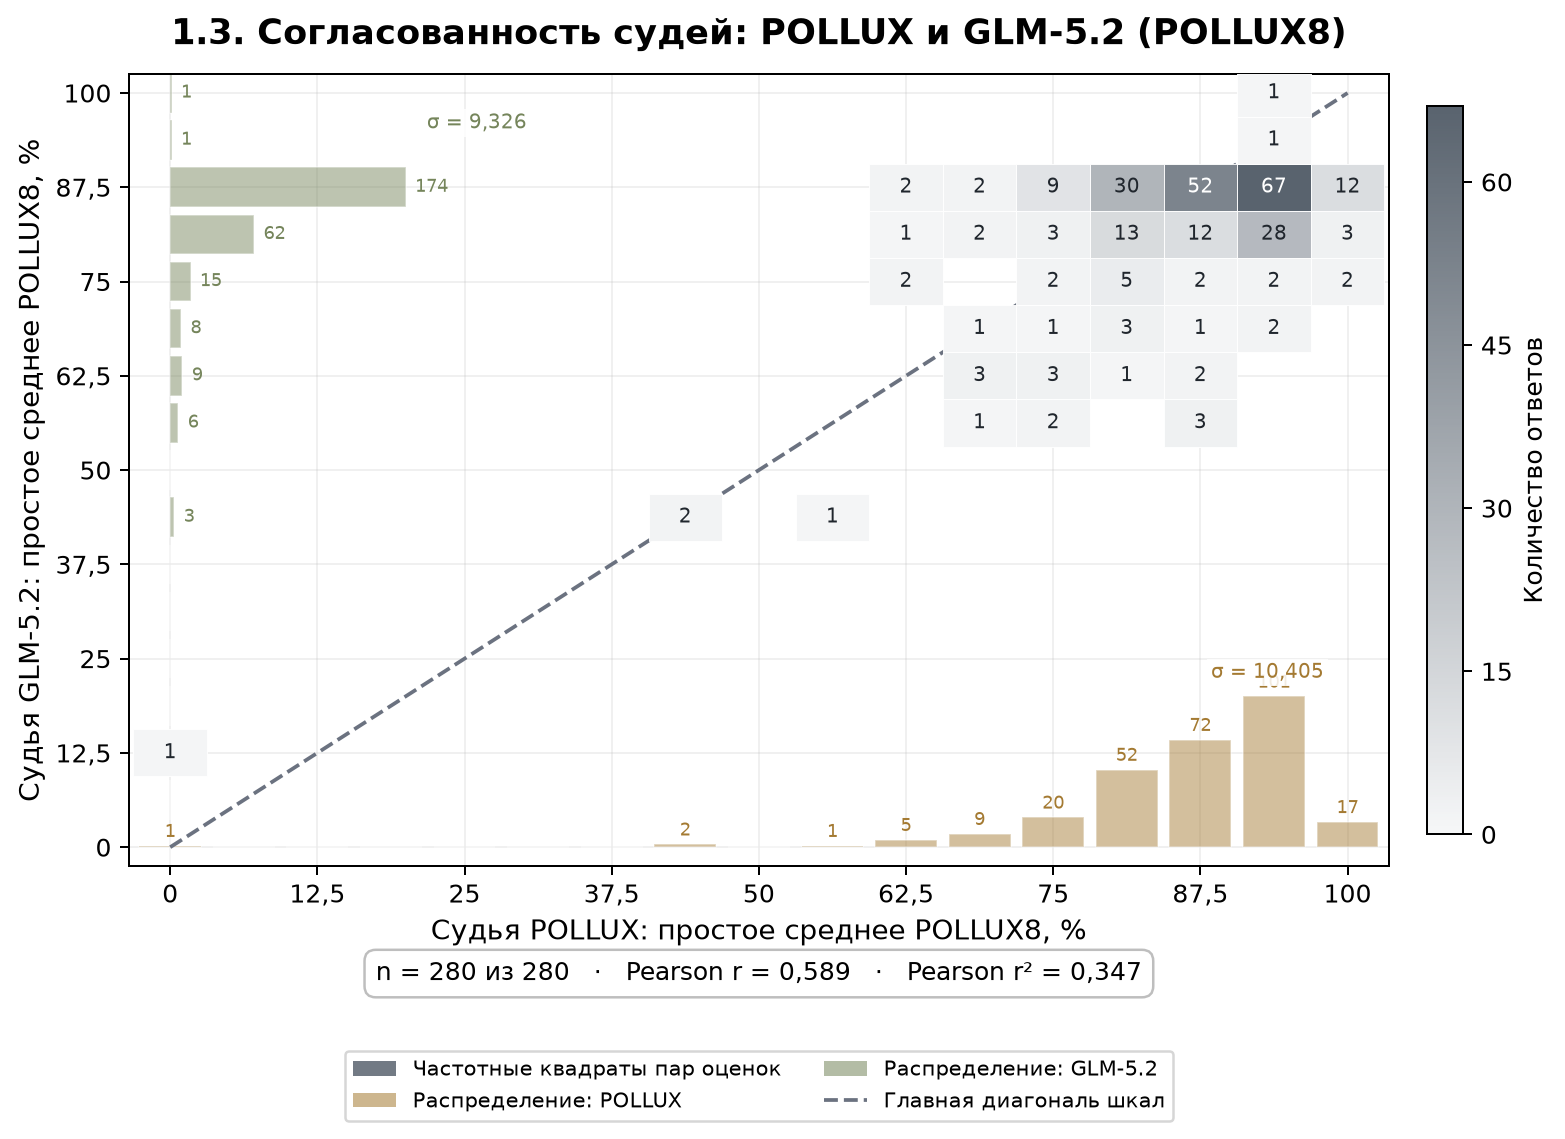
Рисунок 4.3. Согласованность моделей-судей POLLUX и GLM-5.2.
Интерпретация
Модели-судьи согласуются друг с другом заметно сильнее, чем каждая из них — с экспертами-философами. Это означает, что автоматические модели-судьи могут разделять общую «машинную оптику»: одинаково реагировать на структуру и стиль, использовать сходные шаблоны оценивания, быть чувствительными к формальным признакам ответа и одновременно пропускать содержательные дефекты, которые замечают эксперты.
Поэтому высокая согласованность двух LLM-судей не может служить заменой экспертной калибровке.
5. Различающая способность критериев
Второй блок экспериментов посвящён исследованию вариативности, или различающей способности, критериев. Для бенчмарка целесообразно использовать только те критерии, которые дают достаточную вариативность оценок. Критерии, присваивающие всем или почти всем ответам одинаковые баллы, не обеспечивают необходимой разрешающей способности.
Проанализированы два набора:
- восемь критериев POLLUX, выбранных из пятнадцати критериев, на которых обучалась или дообучалась модель;
- десять критериев Article10, подготовленных предыдущей командой проекта философского бенчмарка.
Рисунок 5.1. Вариативность восьми критериев POLLUX при использовании модели-судьи POLLUX
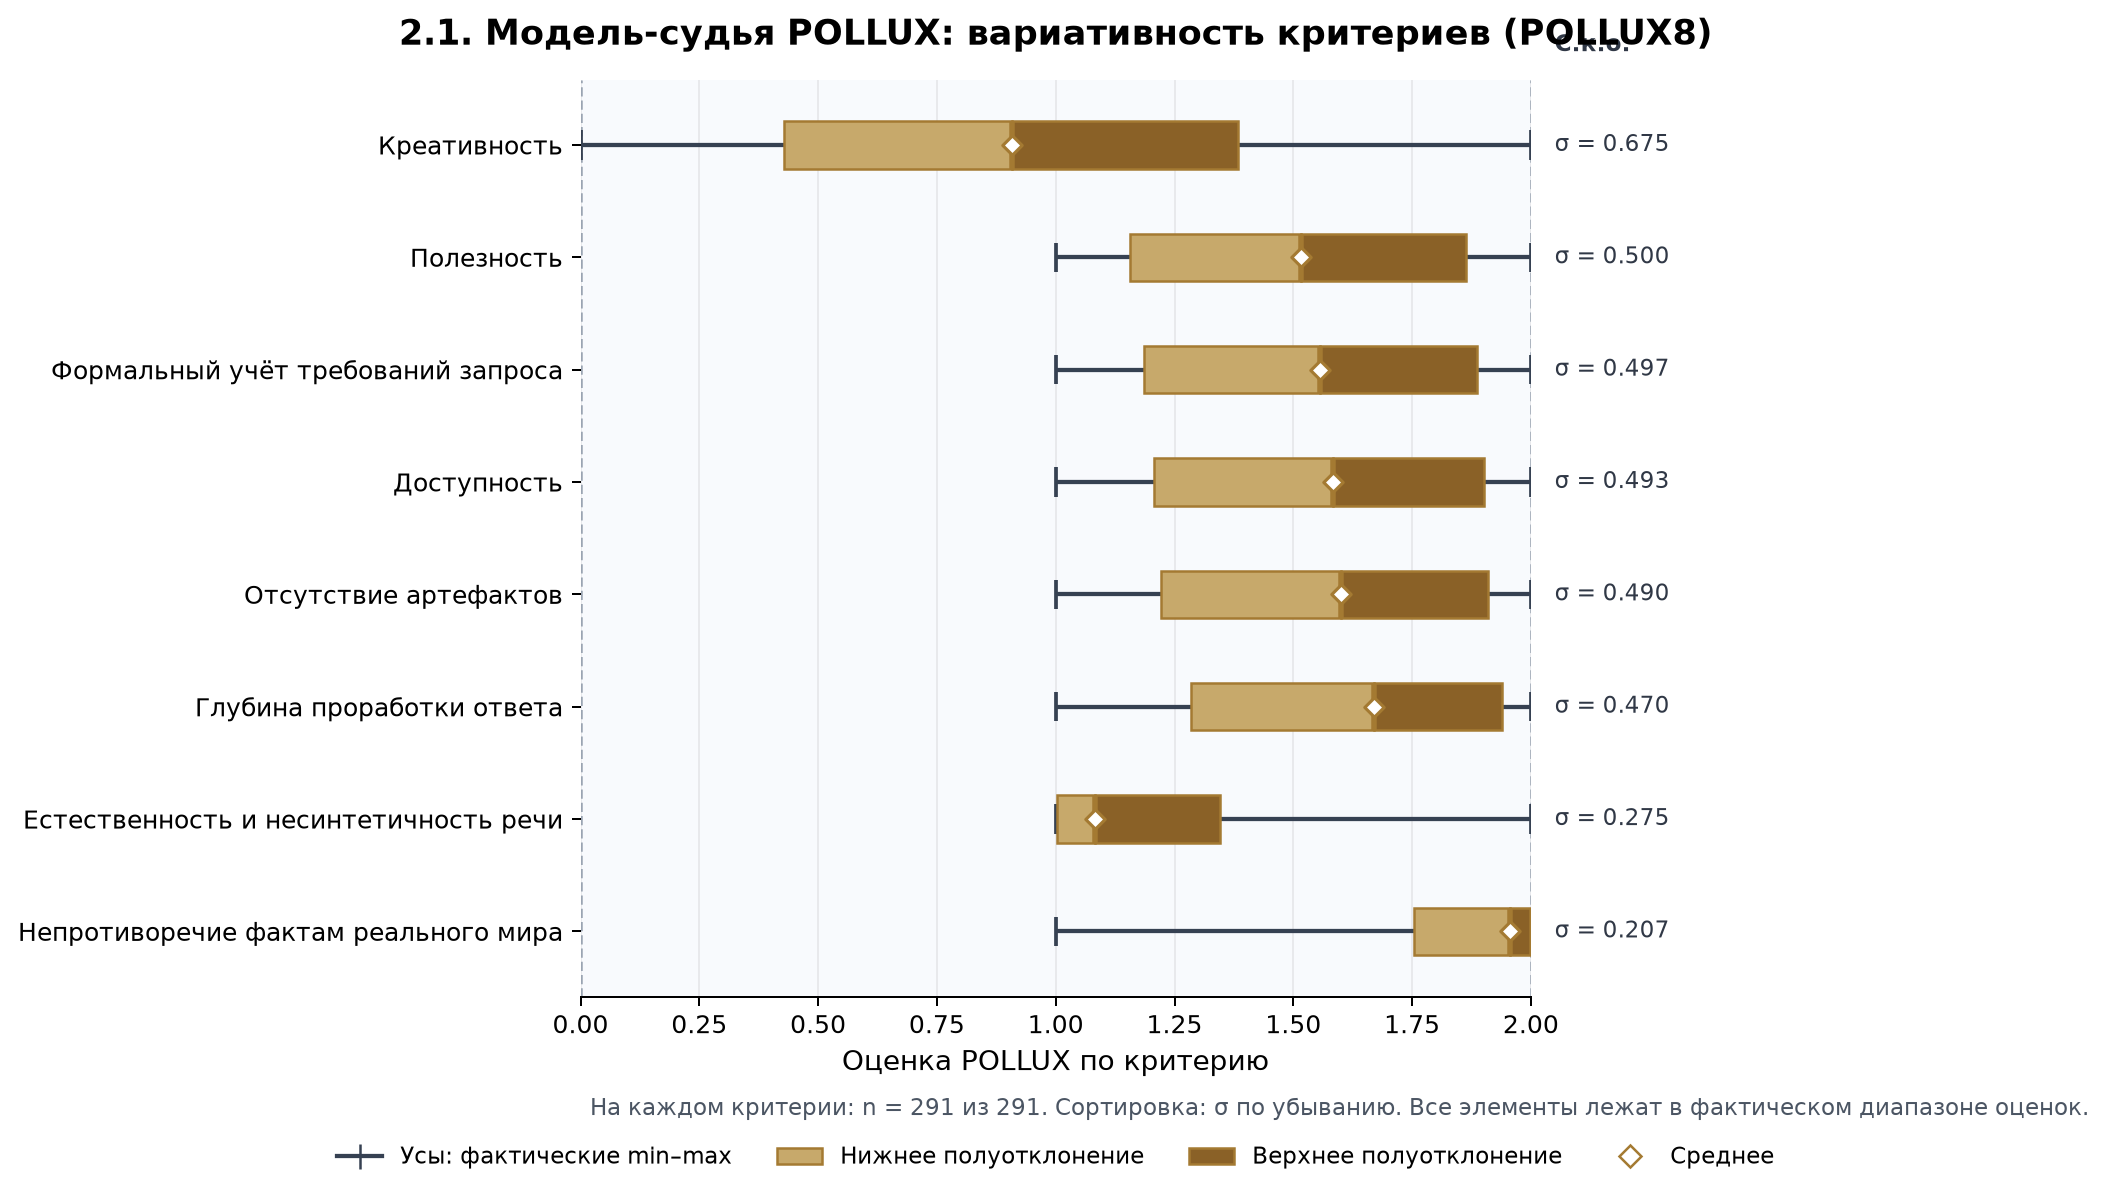
Рисунок 5.1. Вариативность восьми критериев POLLUX при использовании модели-судьи POLLUX.
Интерпретация
POLLUX не использует шкалу равномерно. Креативность обеспечивает основную вариативность; пять критериев дают умеренное разделение, но не используют нулевую часть шкалы; естественность речи различает ответы слабо; непротиворечие фактам почти вырождено у максимума.
Креативность — центральный источник различения у POLLUX, но для академического философского ответа это не обязательно ключевой показатель. Креативный ответ может быть оригинальным, но неточным; риторически сильным, но источниково необоснованным; убедительным, но приписывающим автору чужую позицию.
По семи критериям почти отсутствуют нулевые оценки. Следовательно, модель-судья редко маркирует ответ как существенно несостоятельный даже тогда, когда эксперты находят серьёзные недостатки.
Рисунок 5.2. Вариативность POLLUX8 при использовании модели-судьи GLM-5.2
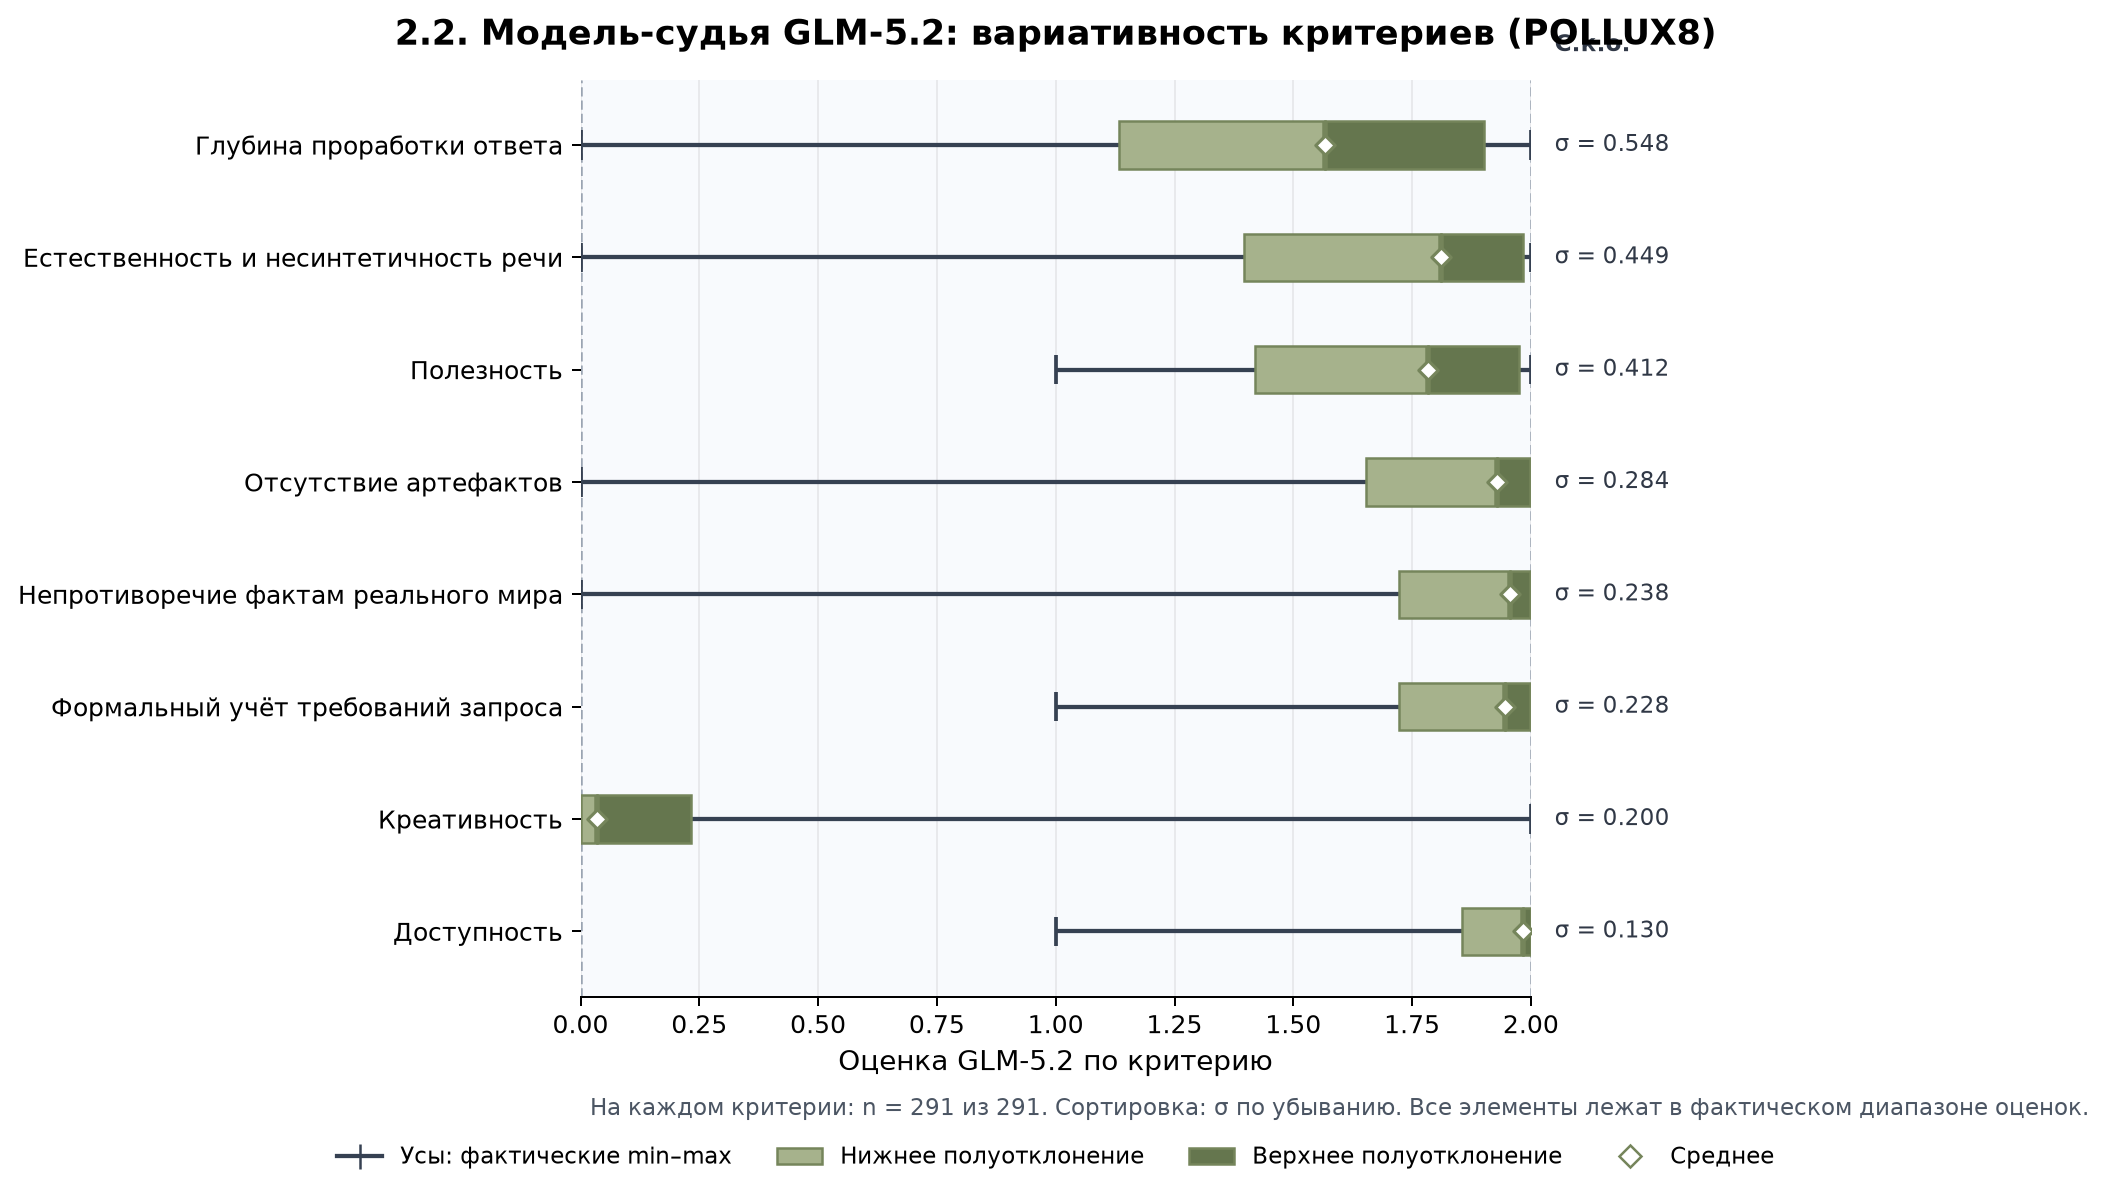
Рисунок 5.2. Вариативность POLLUX8 при использовании модели-судьи GLM-5.2.
Интерпретация
GLM-5.2 полностью меняет профиль тех же критериев. Наиболее показательный пример — креативность: у POLLUX среднее равно 0,907 при \(\sigma = 0{,}675\), а у GLM-5.2 — 0,034 при \(\sigma = 0{,}200\). Из 291 ответа GLM-5.2 поставила по креативности 0 баллов 282 ответам, 1 балл — восьми ответам и 2 балла — одному ответу.
То, что для POLLUX было главным источником дифференциации, для GLM-5.2 оказалось почти неработающим критерием. Критерий не существует отдельно от модели-судьи: одинаковая текстовая рубрика не гарантирует одинакового измерительного поведения.
При этом содержательно более естественные для философской оценки критерии — глубина проработки и естественность речи — у GLM-5.2 начинают использовать более широкий диапазон.
Рисунок 5.3. Вариативность десяти критериев Article10 при использовании модели-судьи GLM-5.2
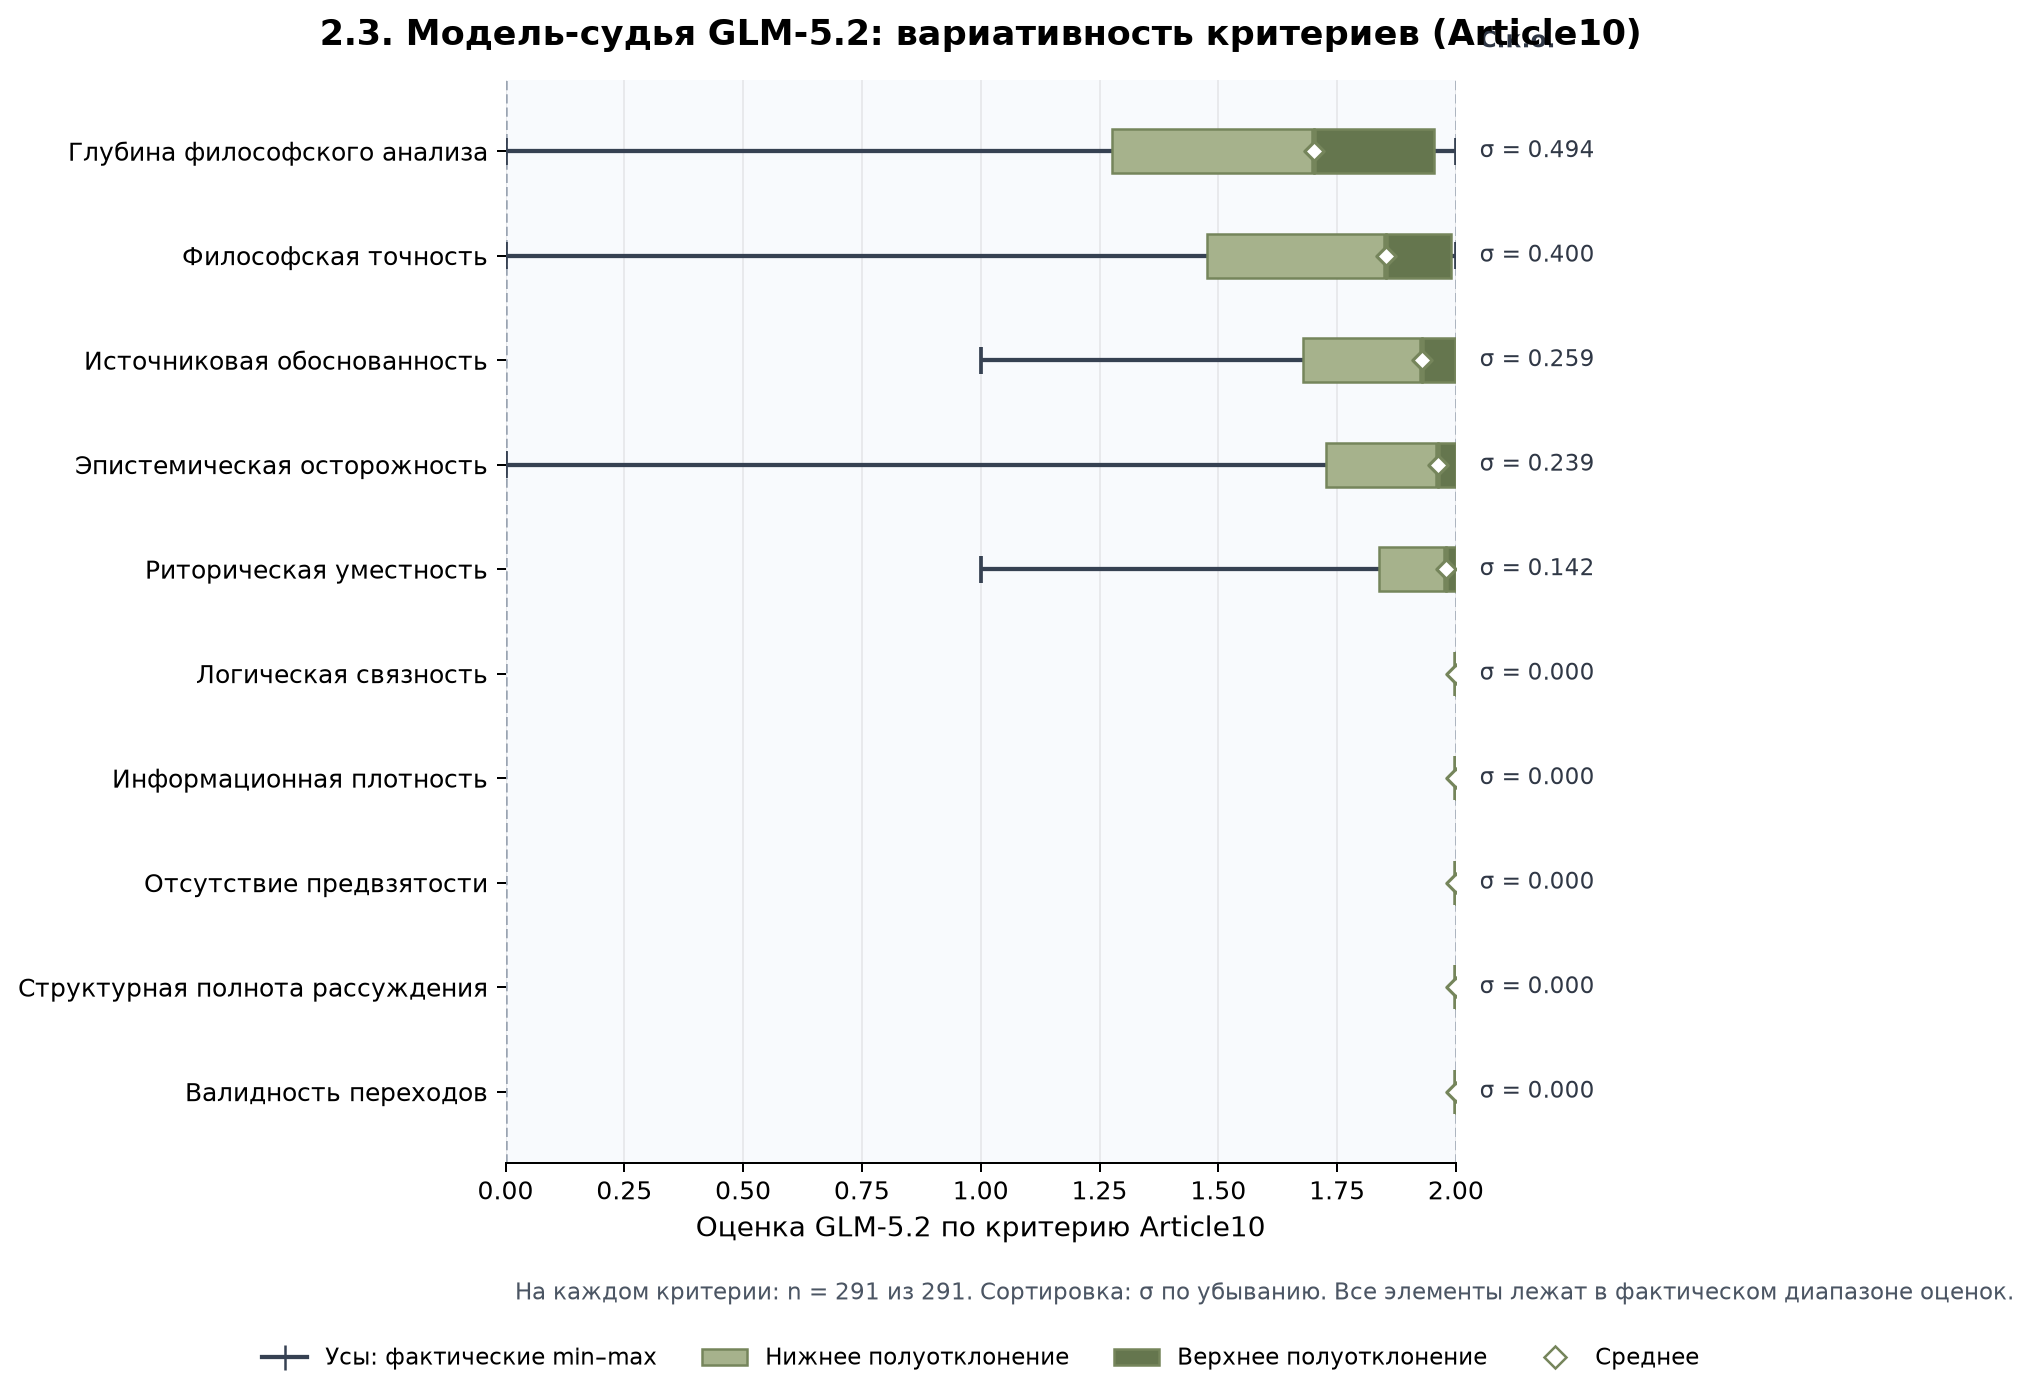
Рисунок 5.3. Вариативность десяти критериев Article10 при использовании модели-судьи GLM-5.2.
Интерпретация
Пять из десяти критериев не различили ни одного ответа. Каждый из 291 ответа получил максимальный балл по логической связности, информационной плотности, отсутствию предвзятости, структурной полноте рассуждения и валидности переходов. Это не дефект визуализации, а результат оценивания моделью-судьёй.
Глубина философского анализа и философская точность привязаны к содержанию ответа. Источниковая обоснованность также использует внешний ориентир. Эти критерии можно сопоставить с эталонным ответом, ключевыми тезисами, авторской позицией, содержанием источника и ожидаемыми ходами рассуждения.
Напротив, критерии вроде логической связности или структурной полноты могут вознаграждать почти любой грамотно организованный LLM-текст. Современные модели умеют создавать внешне связные ответы даже тогда, когда их философское содержание ошибочно.
6. Получение бенчмарков моделей-судей
На третьем этапе исследования была предпринята попытка получить значения бенчмарка, близкие или сопоставимые по качеству с оценками экспертов-философов. Для этого использовались те же модели-судьи и тот же корпус из 291 ответа. Дополнительное разделение ответов на короткие и длинные позволило обнаружить выраженную особенность POLLUX: зависимость оценки от длины ответа.
Рисунок 6.1. POLLUX8: длинные и короткие ответы моделей-респондентов
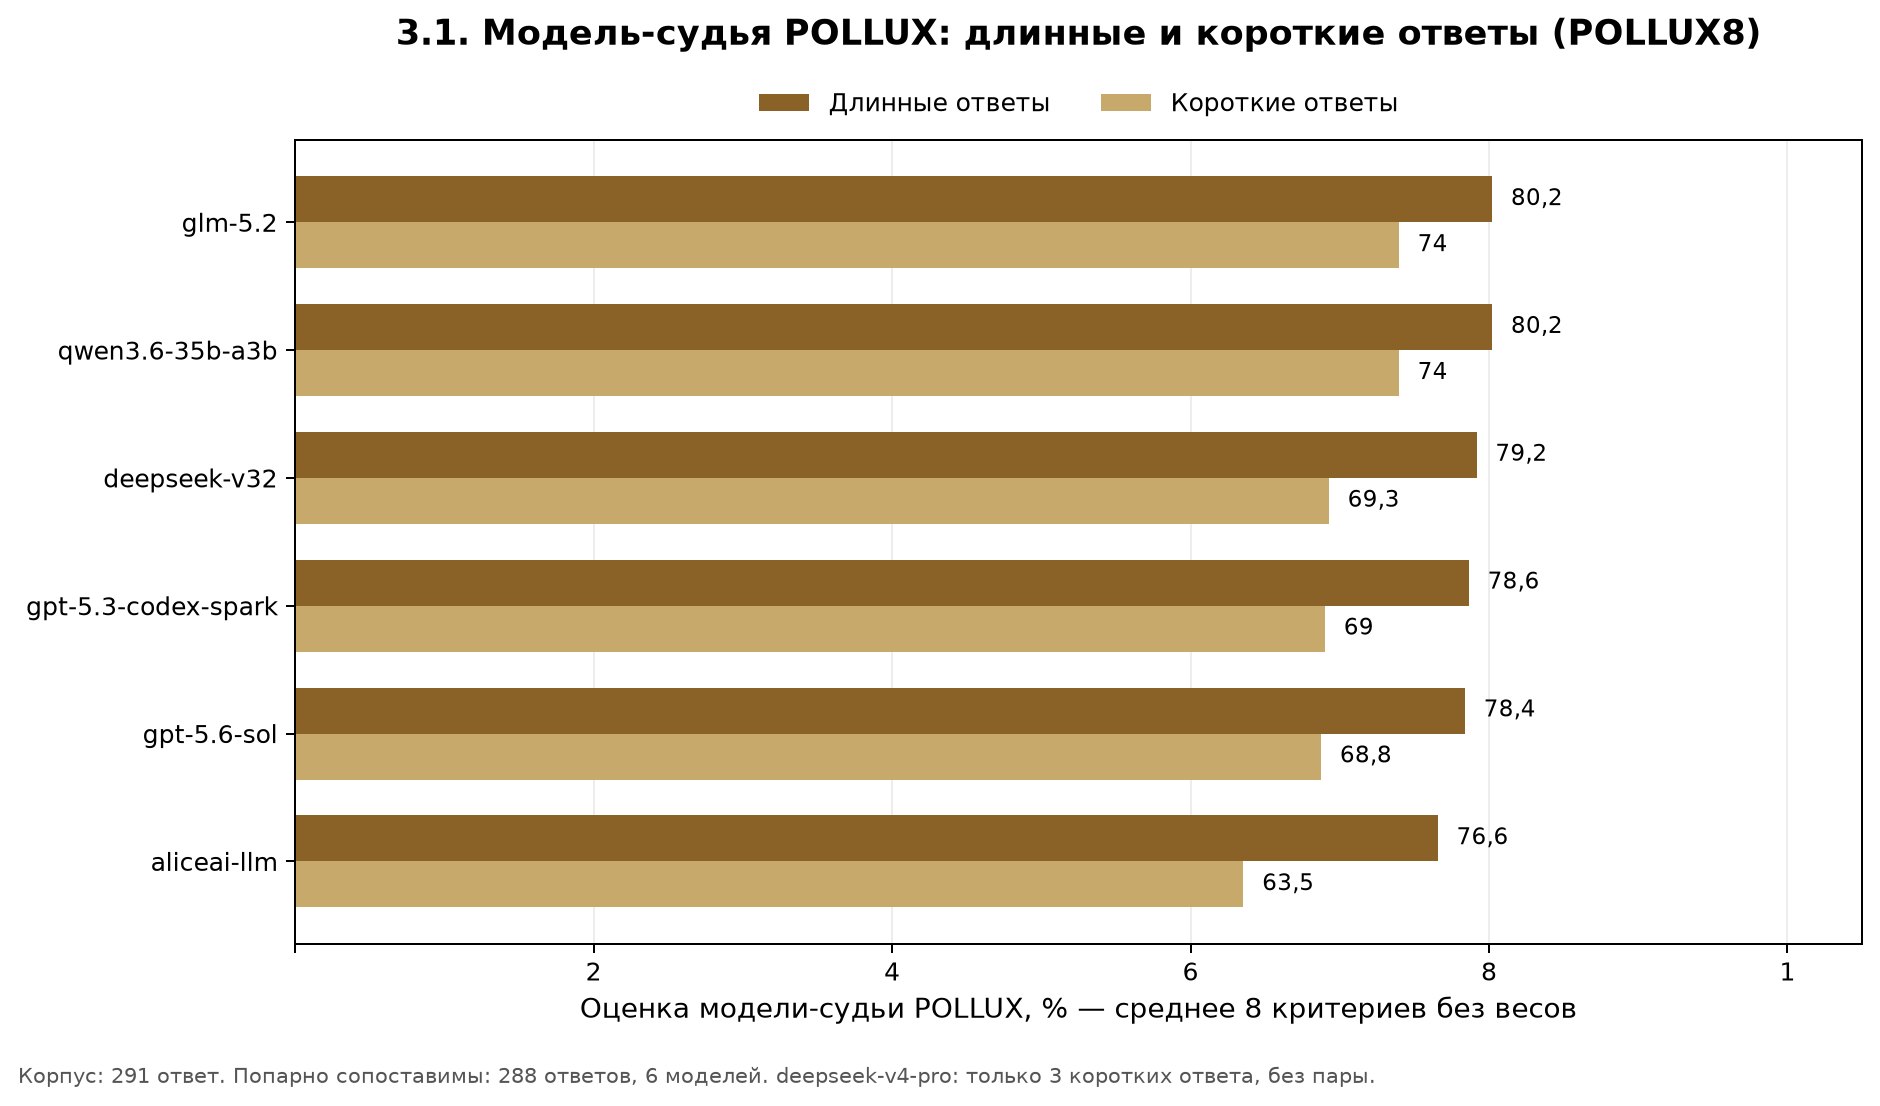
Рисунок 6.1. POLLUX8: длинные и короткие ответы моделей-респондентов.
Интерпретация
POLLUX систематически предпочитает длинные ответы: во всех шести случаях длинный режим получил более высокий результат; разрыв составляет от 6,3 до 13,0 процентного пункта; GPT-5.6 SOL, которую эксперты оценивали наиболее высоко, оказывается лишь на пятом месте по длинным ответам; GLM-5.2 и Qwen получают одинаковые агрегированные оценки.
POLLUX реагирует на объём и внешнюю развёрнутость ответа сильнее, чем требуется содержательному философскому бенчмарку. После определённой длины ответ может получать высокий балл за наличие структуры, объяснений и формального покрытия критериев, даже если его содержательные преимущества не подтверждаются экспертами.
Рисунок 6.2. GLM-5.2 на критериях POLLUX8: длинные и короткие ответы моделей-респондентов
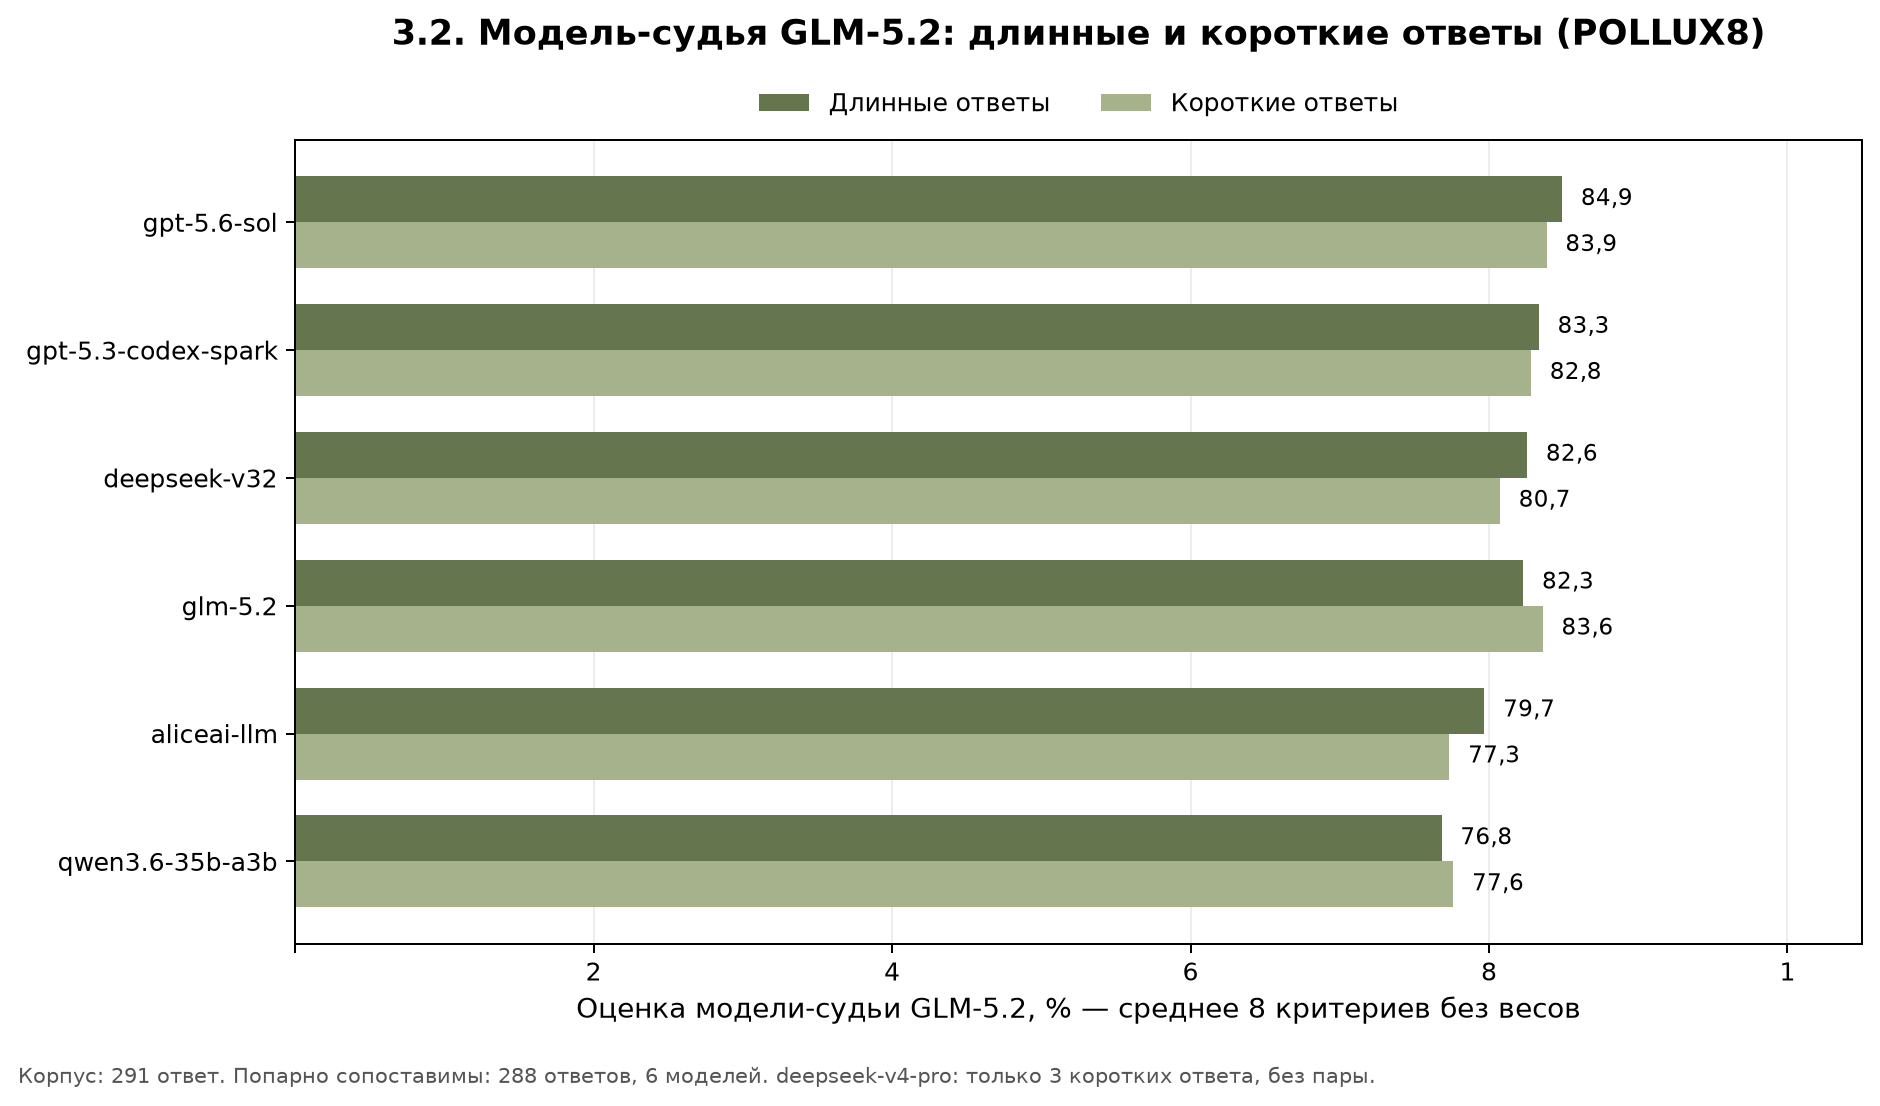
Рисунок 6.2. GLM-5.2 на критериях POLLUX8: длинные и короткие ответы моделей-респондентов.
Интерпретация
У GLM-5.2 смещение, связанное с длиной ответа, значительно слабее: максимальный разрыв составляет 2,3 процентного пункта; у двух моделей короткие ответы получили более высокие оценки; GPT-5.6 SOL занимает первое место.
Это делает GLM-5.2 более подходящей основой для дальнейшей калибровки. Однако GPT-5.3 Codex Spark находится на втором месте, хотя эксперты-философы обнаруживали в её ответах выраженные языковые и терминологические дефекты. Содержательная LLM-рубрика не заменяет формальную проверку качества русскоязычного текста.
Рисунок 6.3. GLM-5.2 на «золотом наборе» из пяти критериев: длинные и короткие ответы
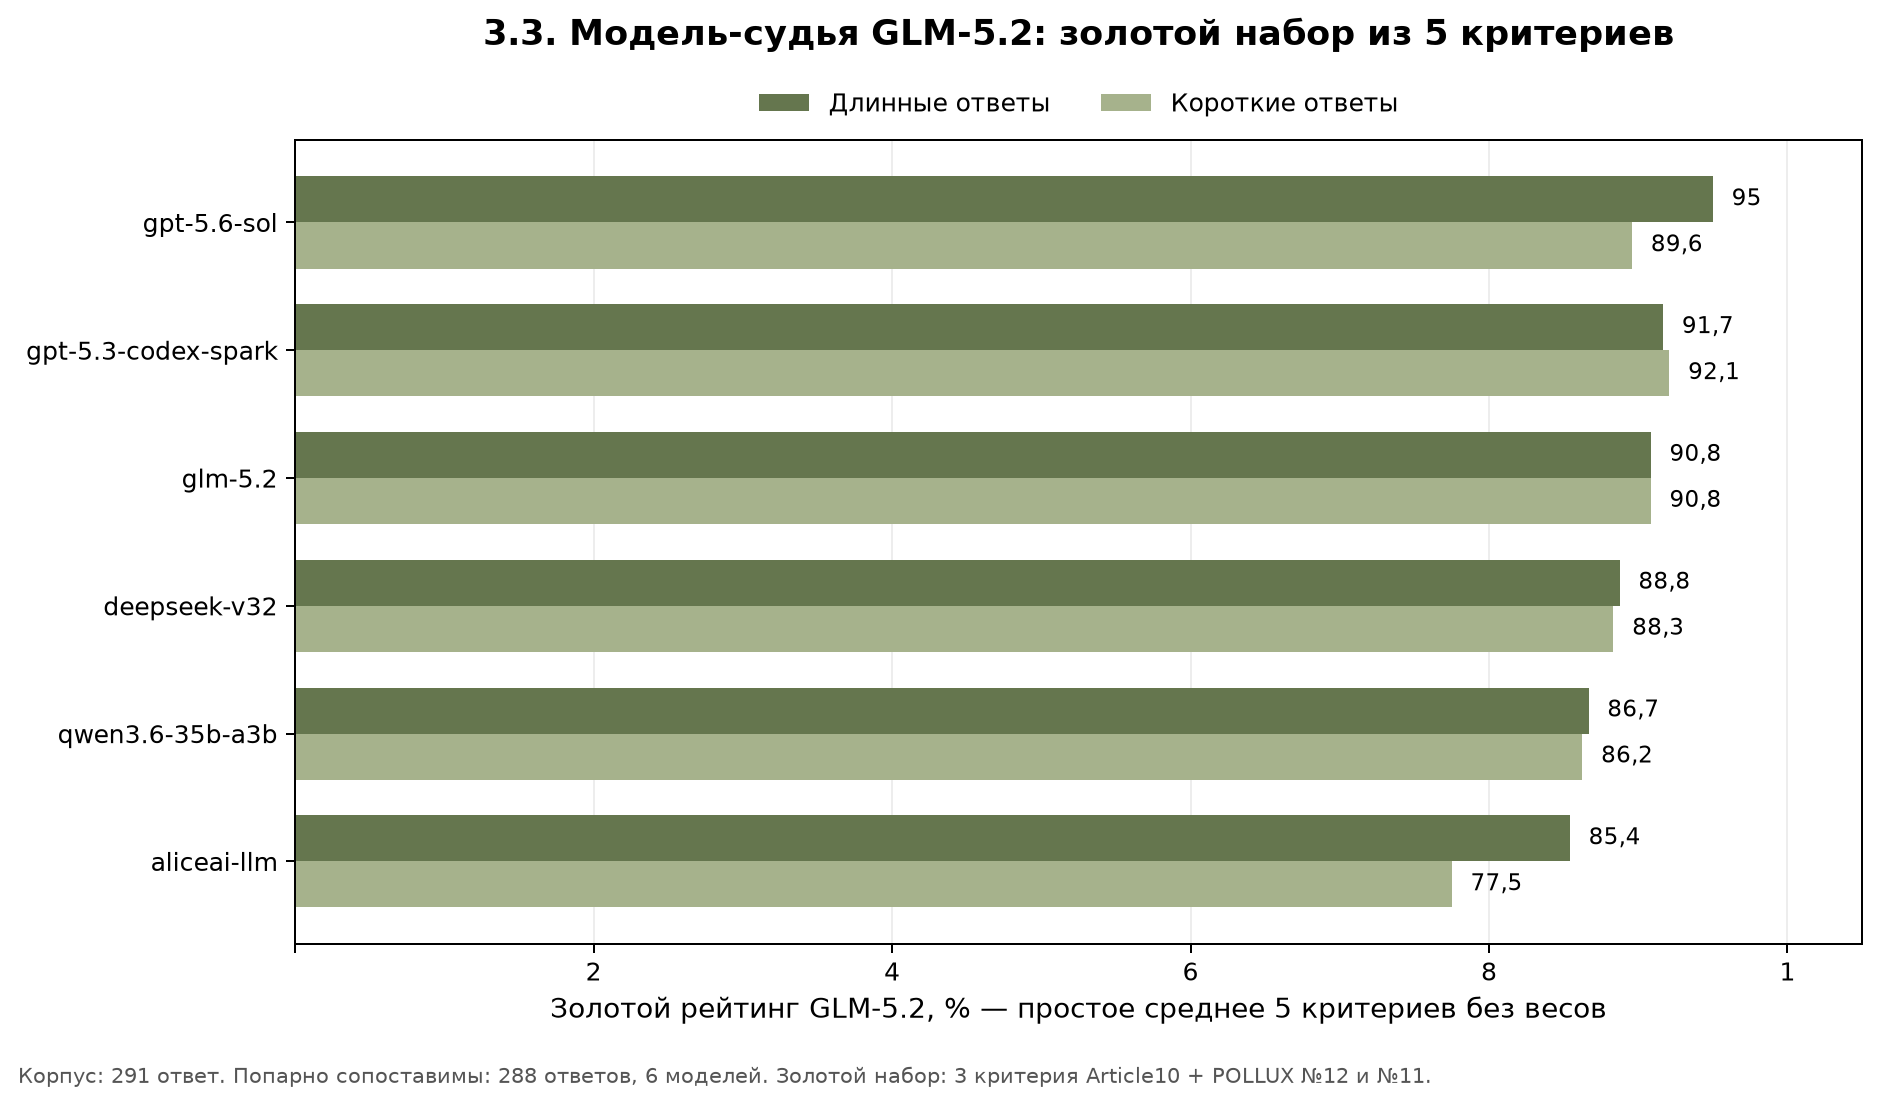
Рисунок 6.3. GLM-5.2 на «золотом наборе» из пяти критериев: длинные и короткие ответы.
«Золотой набор» состоит из пяти критериев с одинаковым весом:
- глубина философского анализа — Article10,
depth_of_analysis; - философская точность — Article10,
philosophical_accuracy; - глубина проработки ответа — POLLUX8, критерий № 12;
- естественность и несинтетичность речи — POLLUX8, критерий № 11;
- источниковая обоснованность — Article10,
source_based_justification.
Для каждого ответа значение рассчитывается как невзвешенное среднее пяти оценок, делённое на максимальную оценку 2 и умноженное на 100%.
Интерпретация
«Золотой набор» выводит GPT-5.6 SOL на первое место, что лучше соответствует экспертным наблюдениям. Однако оценки остаются сжаты у верхней границы: пять из шести моделей получают за длинные ответы более 85%, поэтому различия между сильными и средними моделями невелики и рейтинг недостаточно устойчив к будущему улучшению моделей.
GPT-5.3 Codex Spark остаётся на втором месте. Модель с обнаруженными языковыми дефектами получает 91,7–92,1%. Следовательно, даже отобранные критерии не способны надёжно распознать специфический тип повреждённого русскоязычного ответа. Это подтверждает необходимость отдельного контрольного слоя.
7. Детерминированный языковой контроль
Лексический контур предназначен для выявления признаков, которые можно обнаружить без субъективной LLM-оценки: смешения кириллицы и латиницы внутри слова, чужих письменностей в русскоязычном ответе, подозрительных несловарных лемм, неправильно образованных философских терминов и сломанных словоформ.
В корпусе из 291 ответа:
- 268 ответов прошли проверку без штрафных признаков;
- 23 ответа содержали 37 штрафных признаков;
- 13 признаков связаны со смешением символов разных письменностей внутри одного слова;
- 24 признака связаны с леммами, отсутствующими в используемых словарях.
Детерминированная проверка устанавливает, допустим ли ответ к дальнейшему содержательному оцениванию, и не позволяет модели-судье компенсировать языковой дефект высокими оценками по другим критериям.
8. Сопоставление итогового рейтинга с экспертами-философами
Хотя доля отфильтрованных ответов невелика и составляет менее 10 процентов, их исключение позволяет увидеть существенно иную картину распределения модельных оценок. Результат показывает высокую чувствительность итогового рейтинга к языковым и лексическим дефектам.
Рисунок 8.1. Экспертные оценки и единый рейтинг GLM-5.2 на «золотом наборе» критериев
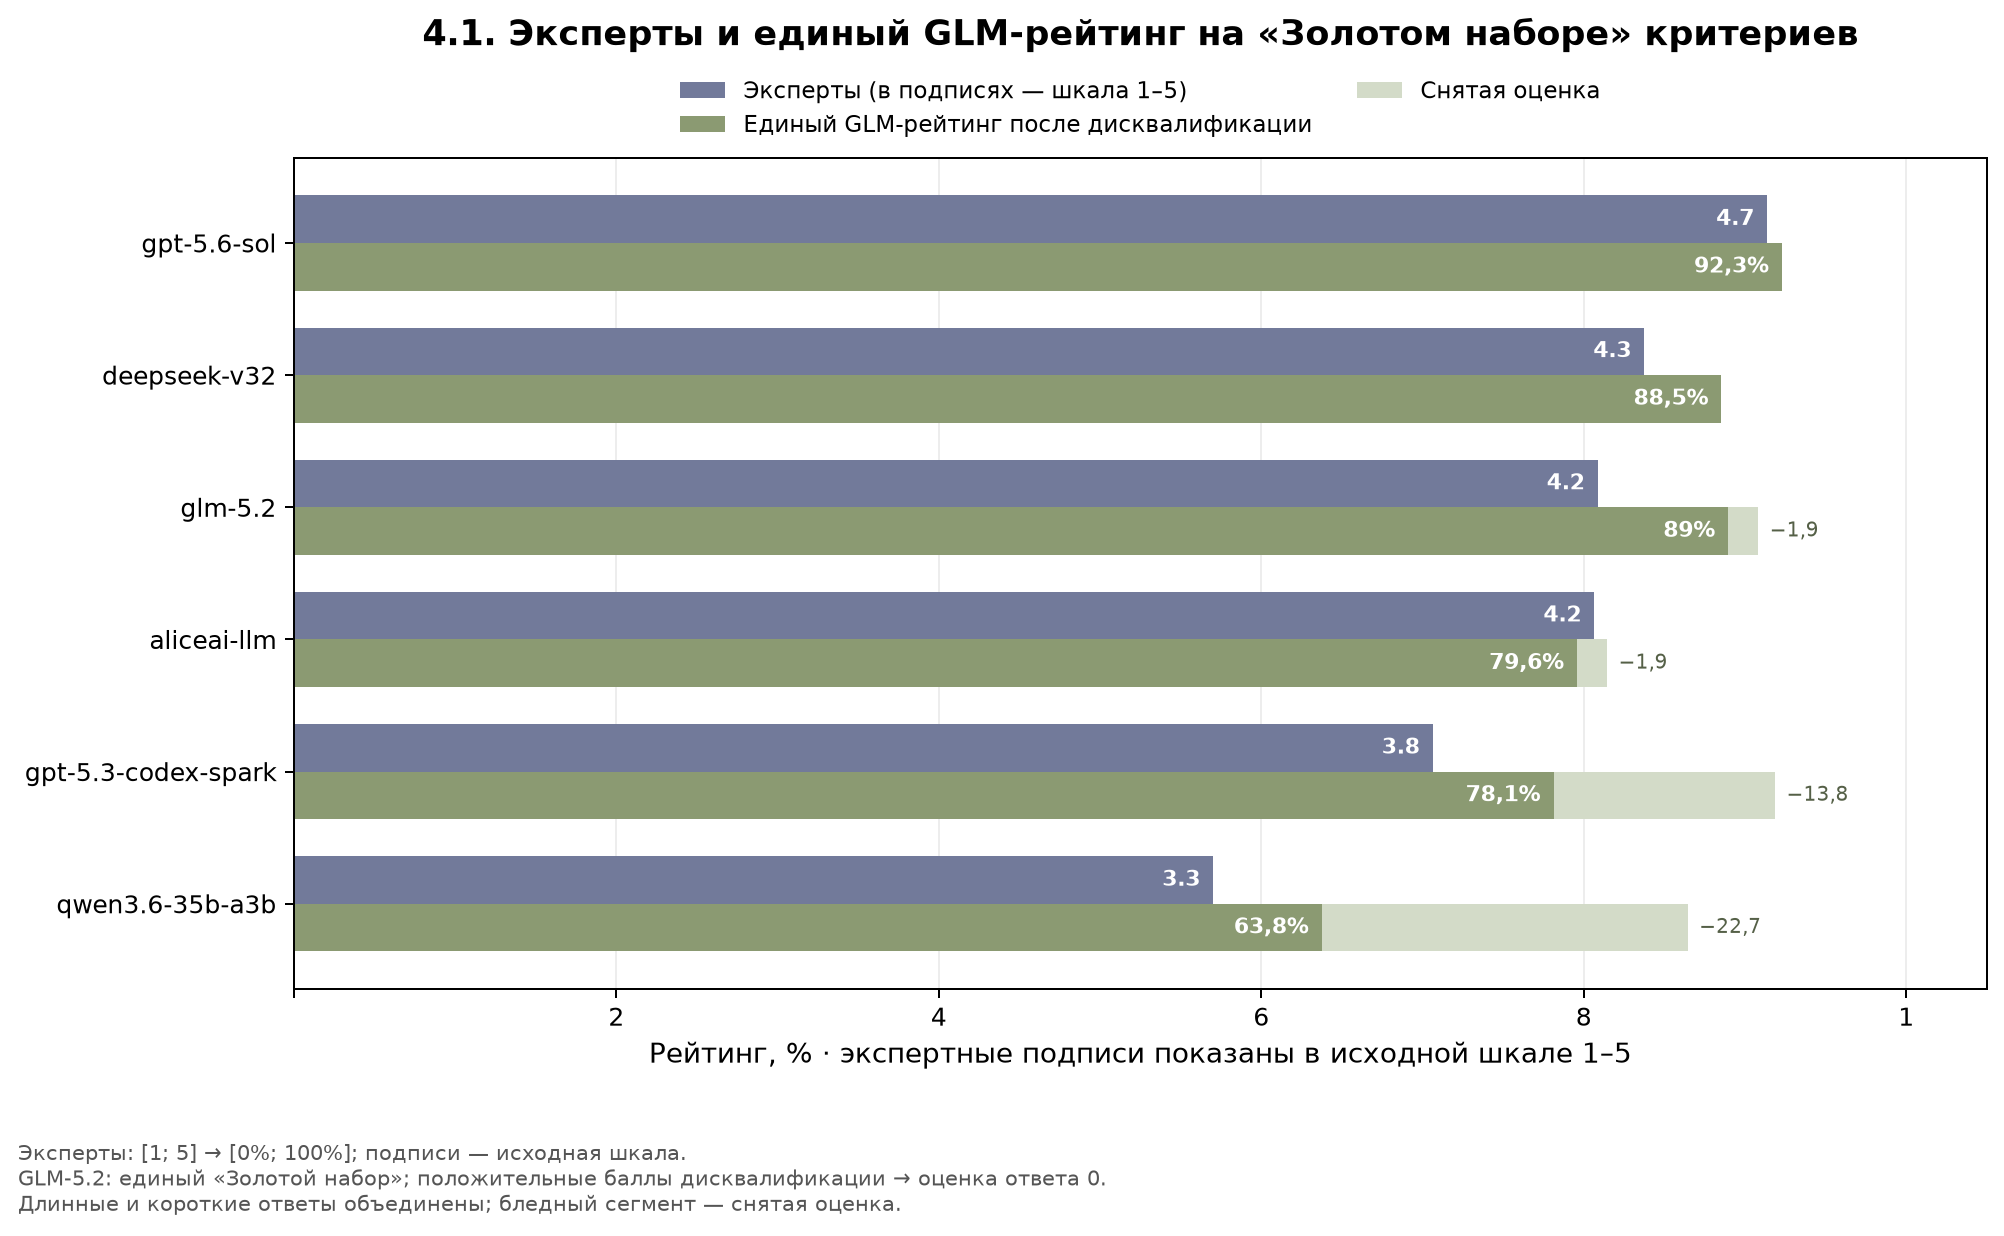
Рисунок 8.1. Экспертные оценки и единый рейтинг GLM-5.2 на «золотом наборе» критериев.
Интерпретация
- GPT-5.6 SOL занимает уверенное первое место;
- Qwen занимает уверенное последнее место;
- GPT-5.3 Codex Spark перемещается из группы формальных лидеров на позицию, лучше соответствующую экспертным оценкам;
- AliceAI получает адекватную оценку;
- DeepSeek V3.2 и GLM-5.2 получают от модели-судьи завышенные оценки;
- систематическое завышение оценки GLM-5.2 может быть связано с тем, что оценивание проводила сама GLM-5.2.
На текущей выборке сочетание содержательной LLM-оценки и отдельной детерминированной проверки даёт рейтинг моделей, практически совпадающий с оценками экспертов-философов.
11. Рекомендации для следующего этапа
11.1. Расширение шкалы оценивания вверх
Модели-судьи можно использовать для различения студенческих ответов, однако современные модели-респонденты часто отвечают лучше уровня, для которого была рассчитана исходная шкала. Эксперты прямо характеризуют некоторые ответы как превосходные или великолепные. Это означает, что верхнюю часть шкалы необходимо расширить и добавить баллы для различения хороших, отличных и выдающихся ответов.
Расширение верхней части шкалы потребует более квалифицированных экспертов. Уровня обычной преподавательской оценки может быть недостаточно. Необходимо привлекать кандидатов и докторов наук, которые глубоко знают соответствующую философскую область и одновременно понимают возможности современных технологий искусственного интеллекта. Речь идёт об узкой группе высококвалифицированных специалистов.
11.2. Ужесточение нижних границ шкалы
Существенная часть текущих оценок сосредоточена в верхней части диапазона. Нижние границы следует ужесточить, чтобы раздвинуть шкалу и повысить разрешающую способность бенчмарка.
Более строгая нижняя граница позволит:
- сильнее учитывать существенные ошибки;
- увеличить различия между ответами;
- сохранить полезность бенчмарка по мере улучшения моделей;
- продлить срок его содержательной применимости.
Для этого необходимо разрабатывать и систематически анализировать большое количество критериев, использовать корпус научных текстов и сочетать инженерную работу с экспертной философской оценкой. Такая работа потребует вычислительных ресурсов.
11.3. Применение автоматических критериев распознавания аномалий в тексте
Использованный на текущем этапе подход основан на частотных словарях, проверке лемм и детекторе символов разных письменностей внутри одного слова. Это простой предварительный метод, который даёт высокую долю ложноположительных срабатываний.
Среди 24 лемм, отсутствующих в используемых словарях, пять срабатываний оказались ложноположительными. Иными словами, примерно каждое пятое обнаруженное таким способом слово не является реальной ошибкой.
При этом итоговый бенчмарк чрезвычайно чувствителен к дисквалификации. Автоматический языковой контроль полезен, поскольку способен существенно повысить качество итогового рейтинга, но именно поэтому его нельзя строить на примитивном фильтре. Необходим более системный подход к распознаванию аномалий, который потребует:
- более качественных языковых ресурсов;
- вычислительной обработки;
- участия специалистов по лингвистике;
- компетенций в области обработки естественного языка;
- отдельной проверки ложноположительных и ложноотрицательных срабатываний.